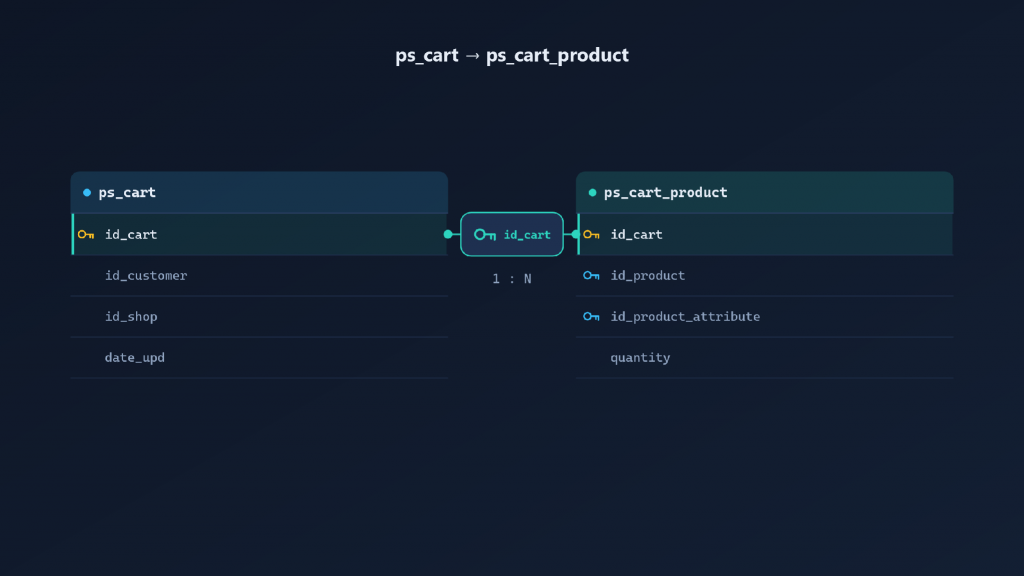
Páginas de productos lentas, un proceso de pago lento, una lista de pedidos que se agota en el Back Office. Nueve de cada diez veces, la base de datos es la responsable, no PHP. Lo que hace que las tiendas con mucho tráfico sean predecibles es dónde se concentra el daño: las consultas SQL lentas en PrestaShop se agrupan alrededor de cuatro tablas que ganan filas diariamente y no pierden ninguna, a saber, ps_cart, ps_cart_product, ps_orders y ps_order_detail. Cuatro pasos las encontrarán. Active el registro de consultas lentas, ordene lo que captura por tiempo total, ejecute EXPLAIN sobre las entradas más problemáticas y luego cambie la consulta o el índice. No hay que adivinar. Cada sección a continuación trata un paso, junto con los patrones que castigan más los datos del carrito y los pedidos.
1.0 ¿Por qué las mesas de carritos y pedidos se convierten en el mayor cuello de botella?
Tu catálogo apenas se mueve. Si lo indexas una vez, su rendimiento es prácticamente el mismo tanto si vendes 1,000 SKU como 50 000. Los datos del carrito y de los pedidos no se comportan así, ya que solo aumentan constantemente.
Cuatro cosas se acumulan a medida que aumenta el tráfico:
- Filas que nunca se van. Casi cualquier visitante que toque la cesta gana una fila en ps_cart, incluidos los bots. Nada hace que esas filas caduquen, por lo que ps_cart y ps_cart_product siguen aumentando mucho después de que las sesiones hayan finalizado.
- Los índices apuntan en la dirección equivocada. Las claves principales favorecen las búsquedas por id_cart o id_order, mientras que los informes, módulos y filtros de administración tienden a buscar por producto, rango de fechas o estado.
- Bucles en lugar de conjuntos. Las reglas del carrito, las promociones y los ganchos de módulos poco cuidadosos manejan un artículo a la vez, lo que convierte una sola visualización de página en docenas de viajes de ida y vuelta.
- El departamento administrativo se suma a esa expansión. Las pantallas de pedidos combinan clientes, estados de pedido, transportistas, países y tiendas, y luego ordenan y paginan la información resultante.
Por lo tanto, las pantallas de pago y administración fallan antes que el catálogo. Tenlo en cuenta. Las páginas de productos rápidas junto a una lista de pedidos que se desplaza apuntan directamente a las tablas del carrito y del pedido.
2.0 Comience con el registro de consultas lentas de PrestaShop.
Empiece aquí. El registro informa sobre lo que su servidor ejecutó realmente bajo tráfico real, no sobre lo que usted supone que ejecutó, y ninguna otra herramienta le ofrece eso gratis.
3.0 Elija un umbral que se adapte a una tienda.
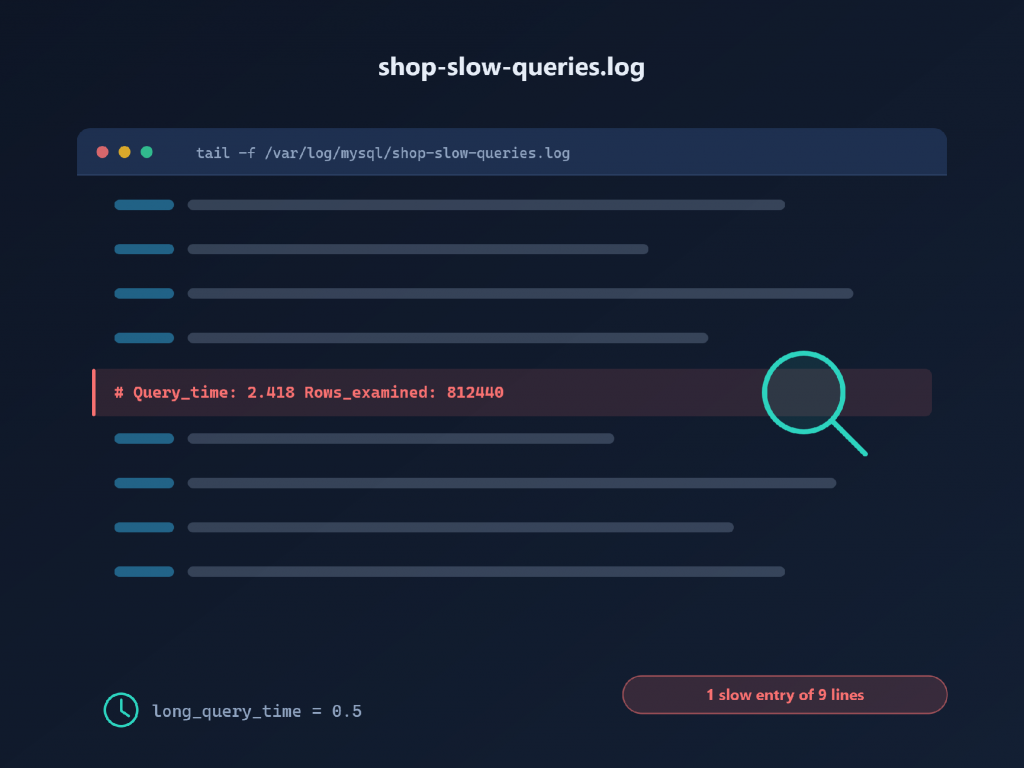
De forma predeterminada, long_query_time se establece en 10 segundos. Para el comercio minorista, esta cifra es irrelevante. Una consulta de carrito de 900 ms pasa completamente desapercibida mientras te cuesta conversiones silenciosamente. Reduce este valor y aprovecha para capturar las consultas sin indexación.
# Ejemplo de configuración de my.cnf: ajústela antes de aplicarla en entornos cercanos a producción.
[Mysqld]
slow_query_log = 1
slow_query_log_file = /var/log/mysql/shop-slow-queries.log
long_query_time = 0.5
log_queries_not_using_indexes = 1
min_examined_row_limit = 1000
log_slow_admin_statements = 1
Comience con 0.5 segundos. Redúzcalo a 0.1 después de eliminar los elementos problemáticos evidentes. Tenga cuidado con un efecto secundario: log_queries_not_using_indexes también detecta lecturas triviales en las tablas de configuración, y min_examined_row_limit es lo que mantiene el archivo legible una vez que lo hace.
Los cambios en tiempo de ejecución también funcionan, aunque con una salvedad. `long_query_time` se aplica a las nuevas conexiones, por lo que los procesos de PHP-FPM que utilizan conexiones persistentes mantienen el umbral anterior hasta que se reinician. La documentación del registro de consultas lentas de MySQL enumera todas las variables relacionadas.
-- Habilitación en tiempo de ejecución. Afecta solo a las nuevas conexiones.
ESTABLECER GLOBAL slow_query_log = 'ON';
ESTABLECER GLOBAL long_query_time = 0.5;
¿Utilizas MariaDB, como muchos proveedores de alojamiento de PrestaShop? Añade `log_slow_verbosity = query_plan,explain`. De esta forma, cada entrada llegará con su plan de consulta adjunto, lo que te ahorrará un análisis posterior.
4.0 Convertir el registro sin procesar en una lista clasificada.
Los registros sin procesar son inutilizables en grandes cantidades, por lo que se recomienda agregarlos mediante la huella digital de la consulta. mysqldumpslow viene incluido con MySQL y no requiere instalación.
mysqldumpslow -st -t 20 /var/log/mysql/shop-slow-queries.log # ordenado por tiempo total
mysqldumpslow -sc -t 20 /var/log/mysql/shop-slow-queries.log # ordenado por número de llamadas
La función pt-query-digest de Percona Toolkit funciona correctamente. Los valores literales se convierten en huellas digitales, las entradas se clasifican por tiempo total y cada una incluye las filas examinadas en comparación con las filas devueltas. Presta atención a este último punto. Ningún otro método indica la falta de un índice de forma tan evidente.
Aquí es donde los equipos se equivocan. Lean el informe por tiempo total en lugar de por el peor escenario. Un informe de tres segundos que se ejecuta dos veces al día cuesta mucho menos que una consulta de carrito de 90 ms que se ejecuta cuarenta veces por cada proceso de compra. Sin embargo, la consulta problemática se corrige y la costosa persiste.
El registro tiene un punto ciego. Una avalancha de consultas rápidas individuales nunca supera el tiempo de consulta prolongado, por lo que no se registra nada. Detecte estos casos con el perfilado de depuración de PrestaShop en una copia de prueba: _PS_DEBUG_PROFILING_ muestra un panel con el número de consultas para cada página. Cientos de consultas en una página del carrito indican que algo está en bucle. No significa que una instrucción sea lenta.
5.0 Lea el plan con MySQL EXPLAIN
Con la lista de opciones preseleccionadas, pregúntele al optimizador qué pretende hacer. Explíquele las estimaciones y nada más. Nunca ejecuta la instrucción, por lo que probarlo en producción es seguro.
EXPLICAR
SELECCIONAR o.id_order, o.reference, o.total_paid, c.lastname
DESDE ps_orders o
UNIR ps_customer c EN c.id_customer = o.id_customer
DONDE o.date_add >= '2026-01-01 00:00:00'
  Y o.estado_actual = 3
ORDENAR POR o.date_add DESC
LÍMITE 50;
Cuatro columnas contienen la mayor parte del significado:
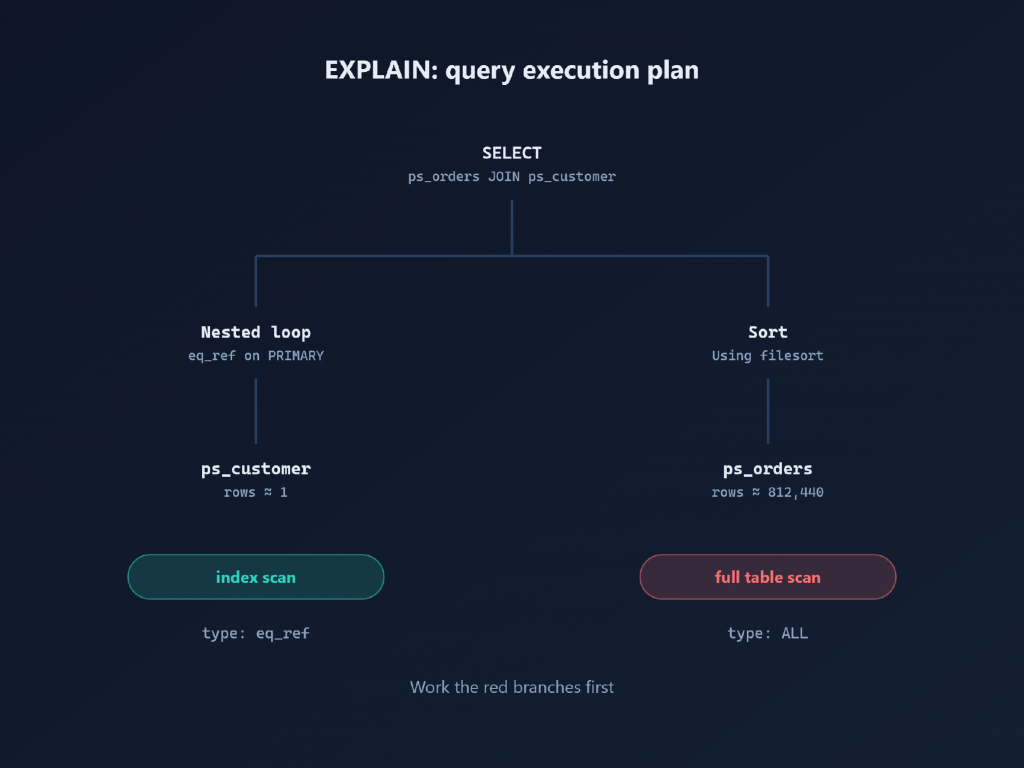
- tipo – el método de acceso. const, eq_ref y ref son correctos. range e index son aceptables. ALL significa un escaneo completo de la tabla, y en un ps_orders grande, ese único valor suele ser el que se encuentra.
- clave – el índice elegido realmente. Cuando possible_keys enumera candidatos pero key muestra NULL, el optimizador los rechaza, a menudo porque una función envuelve la columna filtrada.
- filas y filtradas – el volumen estimado que MySQL debe procesar. Un valor de filas elevado combinado con un porcentaje de filtrado bajo implica que la consulta lee muchos más datos de los que devuelve.
- Extra – las advertencias. Usar `filesort` y `temporary` significa que ningún índice satisface la ordenación. Usar un índice es el caso ideal: un índice de cobertura responde a la consulta sin modificar la tabla.
La documentación de referencia de MySQL EXPLAIN documenta cada valor, y la guía de PlanetScale para leer la salida de EXPLAIN ofrece un modelo mental útil: tratar los tipos de acceso como un semáforo y trabajar primero con los que están en rojo.
6.0 Donde EXPLICAR ANALIZAR se gana su lugar
A partir de la versión 8.0.18, también se incluye EXPLAIN ANALYZE. Esta variante ejecuta la consulta e imprime los tiempos de ejecución y el número de iteraciones junto a las estimaciones, lo que resulta de gran ayuda cuando el plan se lee correctamente pero la consulta sigue siendo lenta. Tenga en cuenta que se ejecuta. Limite su uso a las consultas SELECT de solo lectura durante las horas de menor actividad.
MariaDB cubre el mismo terreno con ANALYZE SELECT, que muestra el número real de filas junto al número previsto. Una gran diferencia entre ambos suele indicar estadísticas desactualizadas. Ejecute ANALYZE TABLE, revise los datos y, posteriormente, decida sobre el índice.
7.0 Patrones comunes de consultas lentas en datos de carrito y pedidos
Aquí se presentan cuatro patrones que abarcan prácticamente todo. Cada uno requiere una solución específica, así que averigüe cuál le afecta antes de modificar el esquema.
7.1 Las búsquedas del lado del producto escanean ps_cart_product
Comprueba tu esquema antes de dar nada por sentado, ya que las instalaciones actualizadas suelen diferir de las nuevas:
MOSTRAR CREAR TABLA ps_cart_product;
MOSTRAR ÍNDICE DESDE ps_cart_product;
En el esquema actual, la clave primaria de ps_cart_product comienza con id_cart. Por lo tanto, las lecturas del lado del carrito ya se ejecutan como búsquedas de índice, y agregar otro índice (id_cart, id_product) no genera más que escrituras más lentas.
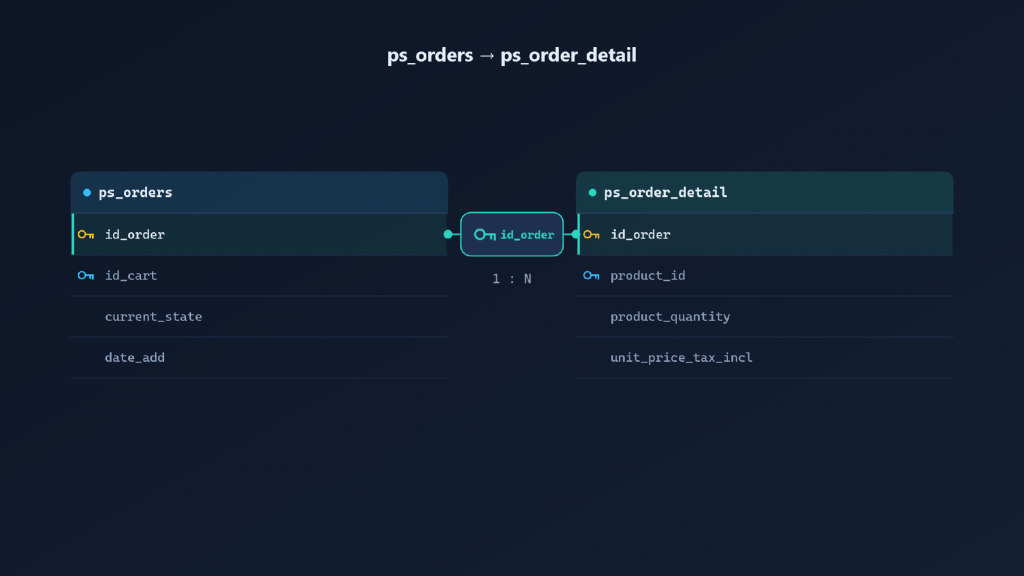
El problema surge en sentido contrario. MySQL lee el índice desde la columna más a la izquierda, por lo que una clave que comience con id_cart no puede servir para una consulta que filtre solo por id_product. Las herramientas de recuperación de carritos abandonados, los widgets de control de inventario y las eliminaciones masivas de productos filtran exactamente de esa manera, y todos terminan escaneando la tabla.
-- Escanea ps_cart_product cuando no hay ningún índice que comience con la columna de producto.
SELECCIONAR CONTAR(DISTINCT cp.id_cart)
FROM ps_cart_product cp
UNIR ps_cart c EN c.id_cart = cp.id_cart
DONDE cp.id_product = 4821
  Y c.date_upd > DATE_SUB(NOW(), INTERVAL 7 DAY);
La optimización de la tabla del carrito de PrestaShop se reduce a esa distinción. Indexa lo que tus módulos realmente consultan y deja intacto lo que el núcleo ya gestiona.
7.2 Las reglas del carrito activan bucles de consulta N+1.
La lógica de promoción gestiona las reglas una por una. PrestaShop recopila las reglas del carrito aplicables, calcula cada valor y cada evaluación verifica sus propias restricciones con las tablas de producto, categoría, transportista, grupo y país. Por lo tanto, diez reglas activas requieren diez evaluaciones, además de sus búsquedas anidadas, en cada renderizado del carrito y cada actualización AJAX.
Cada consulta se ejecuta rápidamente, por lo que el registro de consultas lentas nunca las marca. En cambio, el generador de perfiles revela el siguiente patrón: el número de consultas aumenta al mismo ritmo que el número de reglas activas.
Solucione el problema en el origen, en lugar de modificar los índices. Desactive las reglas caducadas en vez de dejarlas activadas con una fecha de finalización anterior, combine las promociones superpuestas y dé preferencia a las reglas específicas sobre las que abarcan todo el catálogo y que contienen largas listas de restricciones.
7.3 Los filtros de fecha en los informes de pedidos anulan los índices
Envolver una columna en una función hace que su índice sea inutilizable. Los paneles personalizados y las exportaciones CSV hacen esto constantemente.
-- Lento: la función bloquea el acceso al índice.
SELECCIONAR COUNT(*) DE ps_orders DONDE FECHA(date_add) = '2026-03-14';

-- Rápido: un rango semiabierto mantiene el índice en juego.
SELECCIONAR COUNT(*) DE ps_orders
DONDE date_add >= '2026-03-14 00:00:00'
  Y date_add < '2026-03-15 00:00:00';
Los filtros YEAR(date_add) y la agrupación DATE_FORMAT() comparten el mismo defecto. Reescríbelos como rangos donde tengas control sobre el código. Cuando no puedas hacerlo —por ejemplo, dentro de un módulo de código cerrado— MySQL 8.0.13 y versiones posteriores admiten partes de clave funcional, por lo que puedes indexar la expresión en sí. MariaDB no tiene un equivalente, aunque una columna generada indexada logra el mismo resultado.
7.4 Las pantallas de pedidos de Back Office se unen demasiado
La lista de pedidos del administrador combina las tablas ps_orders y ps_customer, así como las tablas de estado y traducción de pedidos, transportistas, países y tiendas. A continuación, concatena los nombres para la búsqueda, aplica un filtro LIKE, ordena y pagina.
De esto se derivan dos problemas. Al filtrar o ordenar por una columna combinada o traducida, ya sea nombre del cliente, etiqueta de estado o país, no se puede usar un índice en ps_orders, por lo que MySQL primero ensambla el conjunto combinado y luego lo ordena. Peor aún, el costo registra el número total de pedidos en lugar del tamaño de la página, lo que explica por qué la pantalla se degrada a medida que crece la tienda.
Algunas medidas de mitigación no cuestan nada: reducir el tamaño de página predeterminado, mantener el filtro de estado restringido y capacitar al personal para que busque por referencia de pedido en lugar de paginar a ciegas.
7.4 Aplicar soluciones seguras: estrategia de indexación que resista las actualizaciones.
Los índices van al final, nunca al principio. Esta es la secuencia que se mantiene:
- Reescribe cualquier consulta SQL que tengas. Elimina las funciones de las columnas filtradas y suprime las uniones que nadie lee.
- Reduzca la carga de trabajo. Elimine las reglas de carritos inactivos, ajuste los filtros de administración.
- Actualiza las estadísticas usando ANALYZE TABLE y luego ejecuta EXPLAIN por segunda vez.
- Añade un único índice. Mídelo antes y después.
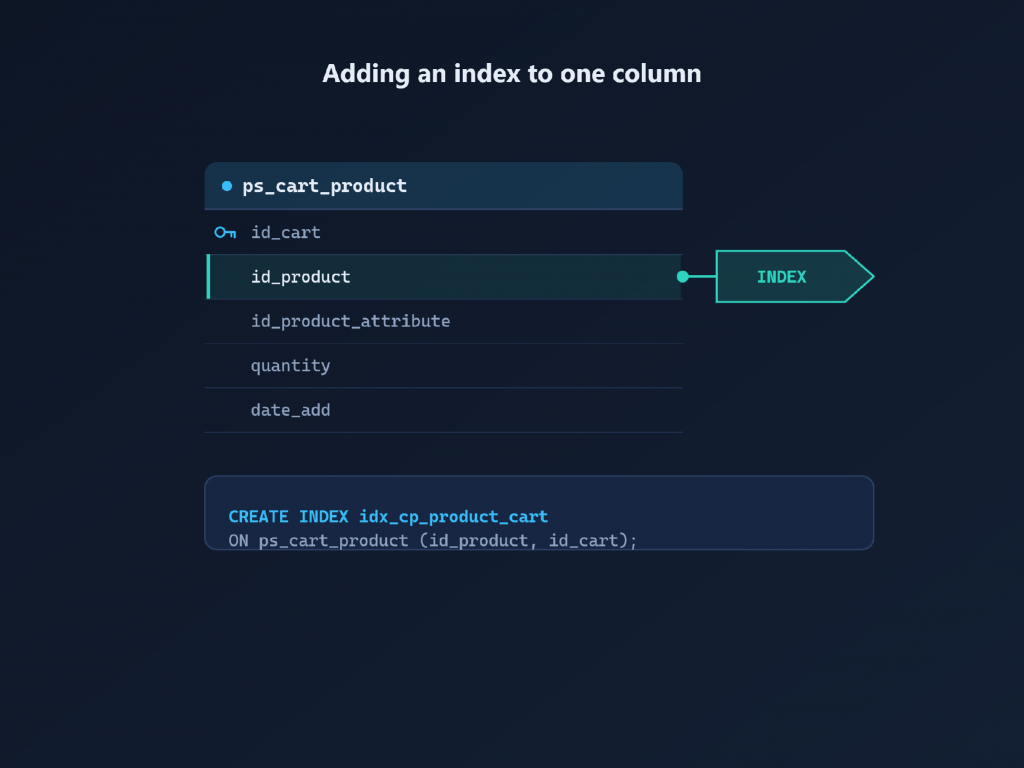
Cada índice ralentiza las escrituras y consume espacio en el grupo de búferes, y las tablas de carrito absorben un tráfico de escritura intenso. Por lo tanto, agréguelas deliberadamente:
-- Ejemplos. Pruebe primero en una copia restaurada de la producción y confirme con
-- MOSTRAR ÍNDICE que no existe ya un índice equivalente.
CREAR ÍNDICE idx_cp_product_cart EN ps_cart_product (id_product, id_cart);
CREAR ÍNDICE idx_cart_dateupd_shop EN ps_cart (date_upd, id_shop);
Algunas reglas mantienen la indexación de la tabla de pedidos de PrestaShop segura ante las actualizaciones del núcleo y de los módulos:
- Nunca Modificar una clave primaria o agregar una restricción UNIQUE a una tabla principal. El código principal depende de la estructura de clave existente, y un índice único puede interrumpir las inserciones legítimas de la página de pago.
- Nunca Se eliminó un índice principal porque una consulta de prueba lo ignoró. Es casi seguro que otro controlador depende de él.
- Añada un prefijo distintivo a los nombres de los índices personalizados para que el siguiente desarrollador pueda diferenciarlos de los del núcleo.
- Mantenga cada índice personalizado en una migración con control de versiones mediante un script de reversión y, a continuación, vuelva a verificarlo después de cada actualización con SHOW INDEX.
- Cree índices en tablas muy grandes durante una ventana de mantenimiento o utilice una herramienta de cambio de esquema en línea, ya que una instrucción ALTER TABLE que bloquee el proceso puede interrumpir las extracciones en tiempo real.
8.0 Elimine y archive los datos antiguos del carrito antes de agregar hardware.
Los índices son útiles, pero reducir el conjunto de trabajo suele ser aún más útil. Los carros abandonados contienen la mayor parte del peso muerto, así que inventaríalos primero:
-- Solo lectura. ¿Qué porcentaje de ps_cart es peso muerto?
SELECCIONAR CONTAR(*) COMO carritos abandonados
DESDE ps_cart c
LEFT JOIN ps_orders o ON o.id_cart = c.id_cart
DONDE o.id_order ES NULO
  Y c.date_upd < DATE_SUB(NOW(), INTERVAL 12 MONTH);
Hay algunas reglas innegociables. Nunca elimine un carrito que tenga un pedido asociado, ya que las pantallas de pedidos y la regeneración de facturas siguen leyendo esos datos. La condición LEFT JOIN … IS NULL mencionada anteriormente es la que le protege. Borre las filas secundarias antes que las principales, incluyendo ps_cart_product, además de cualquier tabla de módulo indexada por id_cart. Realice una copia de seguridad primero, practique con una copia restaurada y luego ejecute las eliminaciones de producción en lotes pequeños en lugar de una sola transacción larga durante el horario comercial.
Conserve los pedidos en sí. Las normas de retención de facturas y registros fiscales varían según la jurisdicción, por lo que, cuando necesite reducir el número de registros, archive en lugar de eliminar.
Las tablas se rellenan, lo que significa que una sola limpieza solo te da unos meses de margen. Crea un script para la purga, inclúyelo en la comprobación de orden anterior y asigna la tarea a tu planificador. Escribir manualmente las eliminaciones de producción a las 2 de la madrugada es la forma en que ocurren los accidentes. Finaliza con ANALIZAR TABLA para que el optimizador aprenda la nueva distribución de filas.
9.0 Sigue atento, o el rendimiento de la base de datos de PrestaShop retrocederá.
Las regresiones llegan silenciosamente. Una actualización de un módulo envía una consulta descuidada, nadie se da cuenta y las solicitudes de soporte aparecen una semana después. Las comprobaciones rutinarias siempre son más efectivas que la respuesta a incidentes.
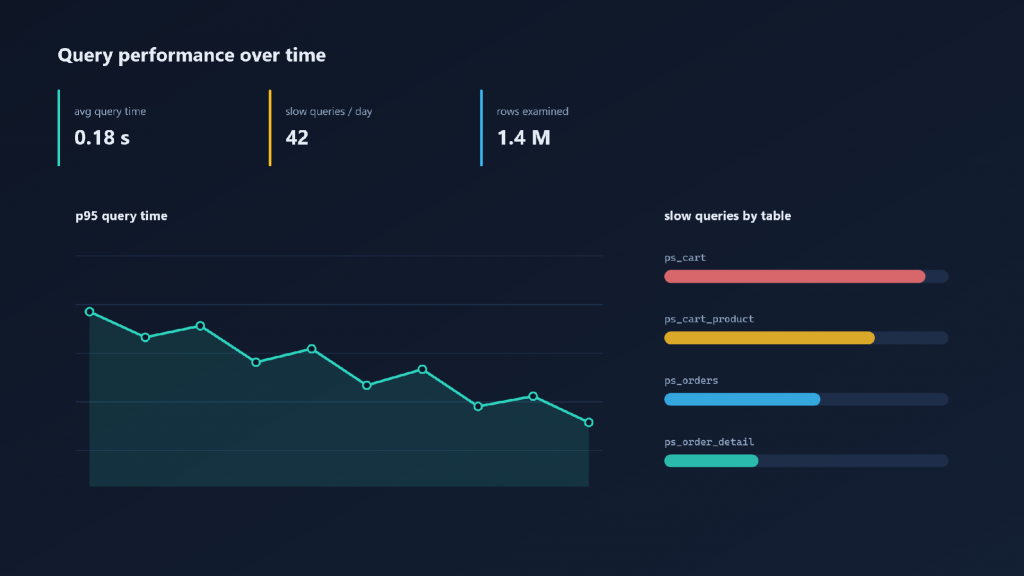
- Programa el resumen. Ejecute pt-query-digest semanalmente sobre los registros lentos rotados y compare las huellas digitales semana tras semana. Las nuevas entradas revelan regresiones tempranamente.
- Consultar las tablas de resumen. El esquema de rendimiento de MySQL agrega cada instrucción de forma continua, y el esquema sys expone vistas legibles como statement_analysis y statement_with_full_table_scans.
- Atribuir consultas al código. Una herramienta APM indica qué hook, controlador o módulo emitió una consulta. El registro de errores identifica la instrucción; APM identifica el código que se debe corregir.
- La escala se lee por separado. PrestaShop documentación de escalado Recomienda una única instancia de escritura con réplicas de lectura, ya que el front office genera muchas más lecturas que escrituras. También sugiere analizar las tablas después de importaciones grandes para que el optimizador trabaje con las estadísticas actuales.
- Dé espacio al grupo de amortiguación. Cuando la base de datos gestiona su propio servidor, aumente el tamaño del búfer de NoDB (innodb_buffer_pool_size) hasta que pueda contener la mayor cantidad posible de memoria de trabajo. Si se deja con un tamaño insuficiente, una tienda PrestaShop con mucho tráfico alcanzará ese límite en cuestión de días.
10.0 Conclusión
Localizar consultas SQL lentas en PrestaShop requiere un trabajo metódico, no de detective. Registra la actividad con un umbral adecuado, ordena por tiempo total y ejecuta EXPLAIN sobre la consulta que aparezca primero. Luego, analiza el plan sin modificarlo. Un tipo de dato ALL, una clave NULL o el uso de filesort en Extra te indicarán si necesitas reescribir la consulta o crear un índice.
Después, trabaja con los datos. Elimina los carritos abandonados, archiva los registros antiguos, verifica las mejoras con consultas reales en lugar de pruebas sintéticas y programa las comprobaciones para que las regresiones se detecten antes de que los clientes las encuentren. Las tiendas que siguen este ciclo mantienen la capacidad de respuesta del proceso de pago a medida que aumenta el volumen de pedidos, y su sistema de gestión administrativa sigue siendo utilizable a gran escala.
Si solo puedes hacer una cosa esta semana, habilita el registro de consultas lentas en tu tienda con mayor actividad y lee las diez primeras entradas. Esa simple lista suele indicar dónde debes invertir tiempo en la base de datos el próximo mes.
En Knowband, ayudamos a los propietarios de tiendas PrestaShop a mejorar el rendimiento, la escalabilidad y la estabilidad mediante plugins fiables para PrestaShop, el desarrollo de funciones personalizadas para sitios web y el desarrollo de aplicaciones.
¿Necesitas ayuda? Contáctanos en [email protected] o visita el servicio de asistencia de Knowband.


)