Opóźnione strony produktów, opóźniony proces realizacji zamówienia, przekroczenie limitu czasu listy zamówień w Back Office. W dziewięciu przypadkach na dziesięć odpowiedzialna jest baza danych, a nie PHP. To, co sprawia, że ruchliwe sklepy są przewidywalne, to miejsce, gdzie koncentrują się szkody: powolne zapytania SQL w PrestaShop gromadzą się wokół czterech tabel, które codziennie dodają wiersze i nie tracą żadnego, a mianowicie ps_cart, ps_cart_product, ps_orders i ps_order_detail. Cztery kroki pozwolą je znaleźć. Włącz dziennik powolnych zapytań, posortuj wyniki według czasu, uruchom EXPLAIN dla najgorszych wpisów, a następnie zmień zapytanie lub indeks. Bez zgadywania. Każda sekcja poniżej opisuje jeden krok wraz ze schematami, które najbardziej obciążają dane koszyka i zamówienia.
1.0 Dlaczego tabele koszyków i zamówień stają się największym wąskim gardłem
Twój katalog prawie się nie zmienia. Zindeksuj go raz, a działa tak samo, niezależnie od tego, czy sprzedasz 1,000, czy 50 000 jednostek SKU. Dane koszyka i zamówienia zachowują się zupełnie inaczej, ponieważ stale rosną.
Wraz ze wzrostem ruchu drogowego, następują cztery rzeczy:
- Rzędy, które nigdy nie ustają. Prawie każdy użytkownik, który dotknie koszyka, zyskuje wiersz w ps_cart, wliczając boty. Nic nie wygasza tych wierszy za Ciebie, więc ps_cart i ps_cart_product rosną długo po zakończeniu sesji.
- Indeksy wskazują złą drogę. Klucze podstawowe preferują wyszukiwanie według id_cart lub id_order, natomiast raporty, moduły i filtry administracyjne skłaniają się ku wyszukiwaniu według produktu, zakresu dat lub statusu.
- Pętle zamiast zestawów. Zasady koszyka, promocje i niedbałe haki modułów dotyczą jednego elementu na raz, przez co jedno wyświetlenie strony zmienia się w dziesiątki cykli.
- Back Office dołącza do tego rozrostu. Ekrany zamówień łączą ze sobą klientów, stany zamówień, przewoźników, kraje i sklepy, a następnie sortują i dzielą na strony wszystkie otrzymane informacje.
Ekrany kas i administratora zacinają się przed katalogiem. Wykorzystaj to jako wskazówkę. Szybkie strony produktów obok listy zamówień prowadzą bezpośrednio do koszyka i tabel zamówień.
2.0 Zacznij od dziennika powolnych zapytań PrestaShop
Zacznij tutaj. Dziennik rejestruje, co Twój serwer faktycznie uruchomił w rzeczywistym ruchu, a nie to, co Twoim zdaniem uruchomił, i żadne inne narzędzie nie daje Ci tego za darmo.
3.0 Wybierz próg odpowiedni dla sklepu
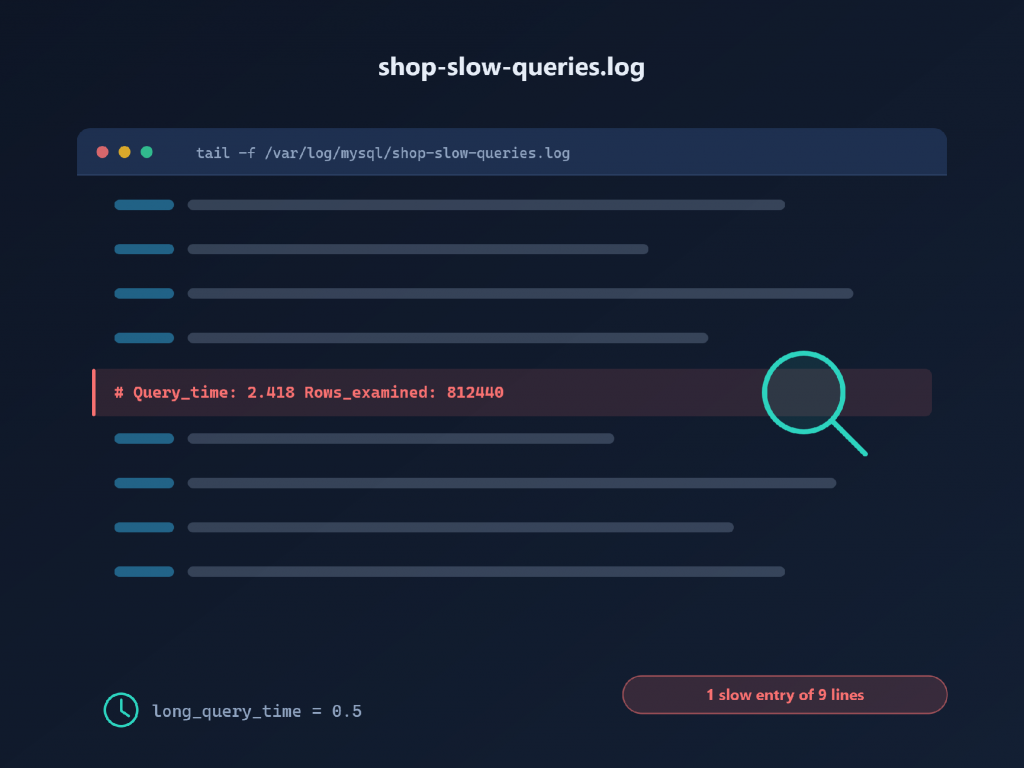
Prosto z pudełka, long_query_time wynosi 10 sekund. W handlu detalicznym ta wartość jest bez znaczenia. Zapytanie o koszyk trwające 900 ms pozostaje całkowicie niewidoczne, a jednocześnie po cichu tracisz konwersje. Zmniejsz tę wartość i przechwytuj zapytania bez indeksu, póki jeszcze jesteś na miejscu.
# Przykładowe ustawienia my.cnf — dostosuj przed zastosowaniem w środowisku produkcyjnym.
[Mysqld]
slow_query_log = 1
slow_query_log_file = /var/log/mysql/shop-slow-queries.log
długi_czas_zapytania = 0.5
log_queries_not_using_indexes = 1
min_examined_row_limit = 1000
log_slow_admin_statements = 1
Zacznij od 0.5 sekundy. Zmniejsz do 0.1 po usunięciu oczywistych błędów. Uważaj na jeden efekt uboczny: log_queries_not_using_indexes wychwytuje również trywialne odczyty z tabel konfiguracyjnych, a min_examined_row_limit to warunek, aby plik był odczytywalny, gdy już się to stanie.
Zmiany w czasie wykonywania również działają, ale jest pewien haczyk. Funkcja long_query_time dotyczy nowych połączeń, więc procesy PHP-FPM działające na stałych połączeniach zachowują stary próg, dopóki nie zostaną one ponownie uruchomione. Dokumentacja dziennika wolnych zapytań MySQL zawiera listę wszystkich powiązanych zmiennych.
-- Włączone w czasie wykonywania. Dotyczy tylko nowych połączeń.
USTAW GLOBALNY slow_query_log = 'WŁ';
USTAW GLOBALNY long_query_time = 0.5;
Uruchamiasz MariaDB, jak robi to wielu hostów PrestaShop? Dodaj log_slow_verbosity = query_plan,explain. Każdy wpis będzie miał wtedy dołączony plan zapytania, co pozwoli Ci zaoszczędzić czas na późniejszej analizie.
4.0 Przekształć surowy dziennik w listę rankingową
Surowe logi są bezużyteczne na poziomie wolumenu, dlatego należy je agregować według odcisku zapytania. mysqldumpslow jest dostarczany z MySQL i nie wymaga instalacji:
mysqldumpslow -st -t 20 /var/log/mysql/shop-slow-queries.log # posortowane według całkowitego czasu
mysqldumpslow -sc -t 20 /var/log/mysql/shop-slow-queries.log # posortowane według liczby wywołań
Narzędzie pt-query-digest z Percona Toolkit działa poprawnie. Wartości literowe są przekształcane w odciski palców, wpisy są klasyfikowane według czasu całkowitego, a każdy z nich zawiera wiersze sprawdzane w porównaniu z wierszami zwróconymi. Zwróć uwagę na tę ostatnią parę. Nic innego nie wskazuje na brak indeksu tak jednoznacznie.
Oto część, w której zespoły popełniają błąd. Czytaj raport według czasu całkowitego, a nie najgorszego przypadku. Trzysekundowy raport, który jest generowany dwa razy dziennie, kosztuje znacznie mniej niż 90-milisekundowe zapytanie o koszyk, generowane czterdzieści razy podczas każdej transakcji. Jednak alarmujące zapytanie zostaje naprawione, a kosztowne zapytanie przetrwa.
W logu jest jednak pewien martwy punkt. Burza pojedynczych, szybkich zapytań nigdy nie przekracza long_query_time, więc nic nie zostaje zapisane. Wyłap je za pomocą profilowania debugowania PrestaShop na kopii tymczasowej: _PS_DEBUG_PROFILING_ wyświetla panel z liczbą zapytań dla każdej strony. Setki zapytań na stronie koszyka oznaczają, że coś się zapętla. Nie oznacza to, że jedno polecenie jest wolne.
5.0 Przeczytaj plan za pomocą MySQL EXPLAIN
Mając gotową listę, zapytaj optymalizator, co zamierza zrobić. Wyjaśnij szacunki i nic więcej. Nigdy nie wykonuje polecenia, dlatego uruchomienie go w środowisku produkcyjnym jest bezpieczne.
WYJAŚNIJ
WYBIERZ o.id_order, o.reference, o.total_paid, c.lastname
Z ps_orders o
DOŁĄCZ ps_customer c NA c.id_customer = o.id_customer
GDZIE o.date_add >= '2026-01-01 00:00:00'
  I o.current_state = 3
ZAMÓW WEDŁUG o.date_add DESC
LIMIT 50;
Najważniejsze znaczenie mają cztery kolumny:
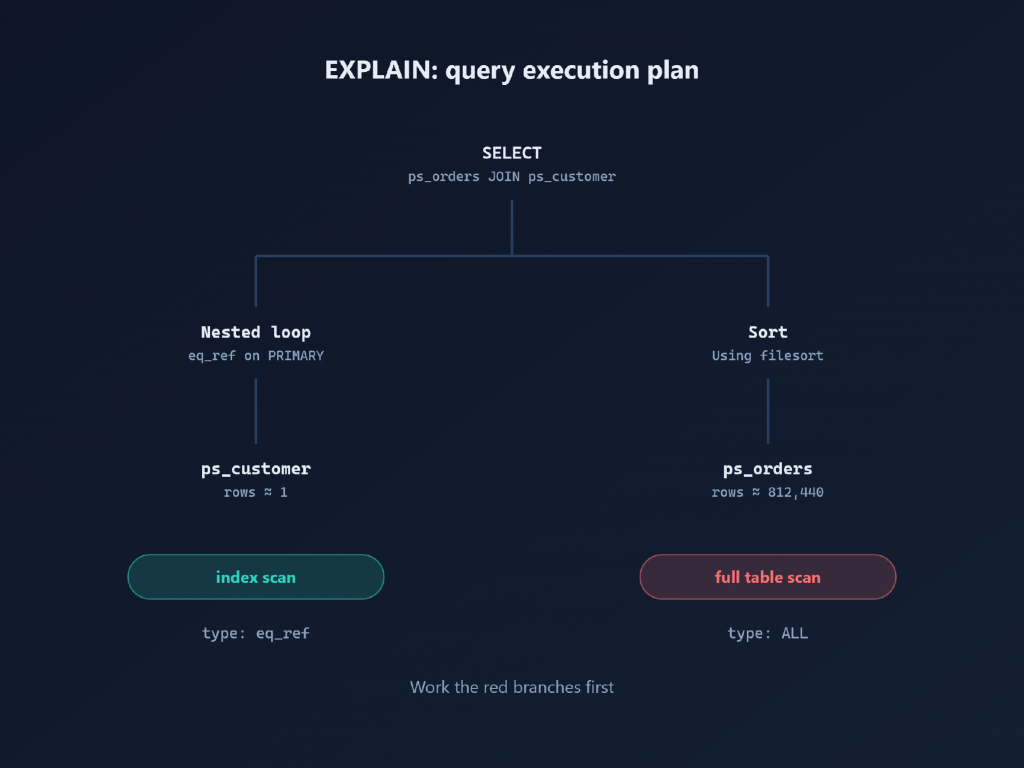
- rodzaj – metoda dostępu. const, eq_ref i ref są prawidłowe. range i index są akceptowalne. ALL oznacza pełne skanowanie tabeli, a w przypadku dużego ps_orders ta pojedyncza wartość jest zazwyczaj twoim odkryciem.
- klucz – indeks faktycznie wybrany. Gdy possible_keys wymienia kandydatów, ale key pokazuje NULL, optymalizator je odrzuca, często dlatego, że funkcja opakowuje filtrowaną kolumnę.
- wiersze i filtrowane – szacowany wolumen, jaki musi obsłużyć MySQL. Duża liczba wierszy w połączeniu z niskim procentem filtrowania oznacza, że zapytanie odczytuje znacznie więcej danych, niż zwraca.
- Extra – ostrzeżenia. Użycie sortowania plików i użycie tymczasowego oznacza, że żaden indeks nie spełnia wymagań sortowania. Użycie indeksu jest dobrym przypadkiem: indeks pokrywający odpowiada na zapytanie bez dotykania tabeli.
Dokumentacja MySQL EXPLAIN dokumentuje każdą wartość, a przewodnik PlanetScale dotyczący czytania wyników EXPLAIN oferuje przydatny model mentalny, polegający na traktowaniu typów dostępu jak sygnalizacji świetlnej i rozpoczynaniu od tych czerwonych.
6.0 Gdzie EXPLAIN ANALYZE zdobywa swoje miejsce
Od wersji 8.0.18 dostępna jest również funkcja EXPLAIN ANALYZE. Ta wersja uruchamia zapytanie i wyświetla zmierzone czasy oraz liczbę pętli obok oszacowań, co jest niezwykle pomocne, gdy plan jest dobrze odczytywany, a zapytanie nadal działa. Należy pamiętać, że jest ono wykonywane. W godzinach ciszy należy ograniczyć je do instrukcji SELECT tylko do odczytu.
MariaDB działa w tym samym zakresie, co ANALYZE SELECT, który wyświetla rzeczywistą liczbę wierszy obok przewidywanej. Duża różnica między nimi zazwyczaj oznacza nieaktualne statystyki. Uruchom ANALYZE TABLE, sprawdź ponownie i podejmij decyzję o indeksie.
7.0 Typowe wzorce powolnych zapytań w danych koszyka i zamówień
Cztery wzorce obejmują niemal wszystko, co się tu pojawia. Każdy wymaga własnego rozwiązania, więc określ, który z nich masz na myśli, zanim sięgniesz po schemat.
7.1 Wyszukiwania po stronie produktu skanują ps_cart_product
Przed podjęciem jakichkolwiek działań sprawdź schemat, ponieważ uaktualnione instalacje często różnią się od czystych:
POKAŻ UTWÓRZ TABELĘ ps_cart_product;
POKAŻ INDEKS Z ps_cart_product;
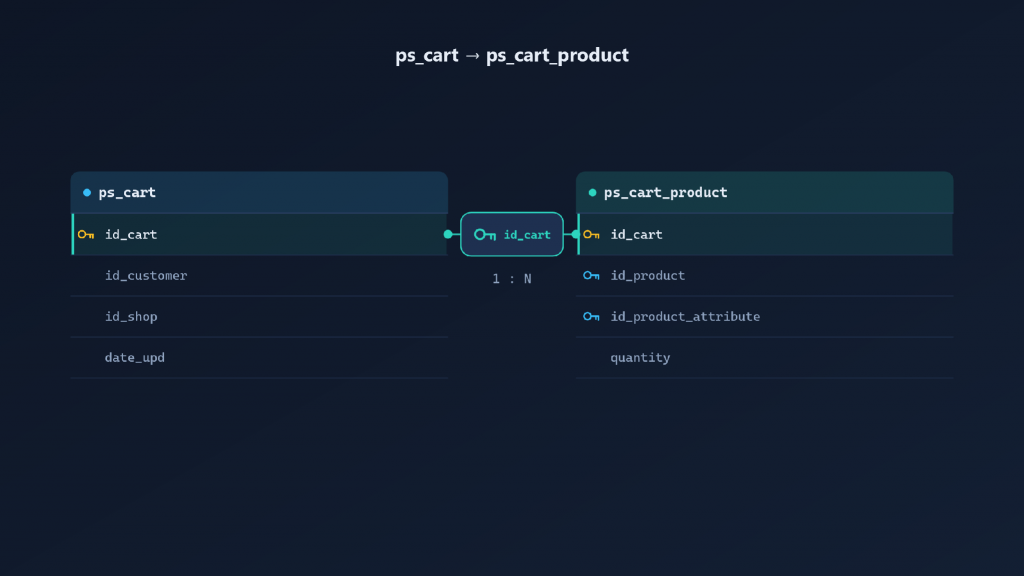
W obecnym schemacie klucz podstawowy ps_cart_product rozpoczyna się od id_cart. Odczyty po stronie koszyka są zatem już wykonywane jako wyszukiwania indeksów, a dodanie kolejnego indeksu (id_cart, id_product) nie powoduje żadnych innych efektów poza wolniejszym zapisem.
Problem zaczyna się w przeciwnym kierunku. MySQL odczytuje indeks z lewej kolumny, więc klucz zaczynający się od id_cart nie może obsłużyć zapytania filtrującego wyłącznie na podstawie id_product. Narzędzia do odzyskiwania porzuconych koszyków, widżety do analizy zapasów i masowe usuwanie produktów filtrują dokładnie w ten sam sposób i ostatecznie przeszukują tabelę.
-- Skanuje ps_cart_product, gdy żaden indeks nie prowadzi do kolumny produktu.
WYBIERZ LICZBĘ(ODMIENNE cp.id_cart)
Z ps_cart_product cp
DOŁĄCZ ps_cart c NA c.id_cart = cp.id_cart
GDZIE cp.id_product = 4821
  AND c.date_upd > DATE_SUB(NOW(), INTERVAL 7 DAY);
Optymalizacja tabeli koszyka w PrestaShop sprowadza się do tego rozróżnienia. Indeksuj to, czego Twoje moduły faktycznie szukają, i zostaw to, co jądro już obsługuje.
7.2 Reguły koszyka wyzwalają pętle zapytań N+1
Logika promocji obsługuje reguły pojedynczo. PrestaShop zbiera odpowiednie reguły koszyka, oblicza każdą wartość po kolei, a każda ocena sprawdza własne ograniczenia w tabelach produktów, kategorii, przewoźników, grup i krajów. Dziesięć aktywnych reguł kosztuje zatem dziesięć ocen plus ich zagnieżdżone wyszukiwania, przy każdym renderowaniu koszyka i każdym odświeżeniu AJAX.
Każde zapytanie jest szybkie, więc log slow nigdy ich nie sygnalizuje. Profiler ujawnia wzorzec: liczba zapytań rośnie wraz z liczbą aktywnych reguł.
Napraw problem u źródła, a nie za pomocą indeksów. Dezaktywuj wygasłe reguły zamiast pozostawiać je włączone z datą zakończenia po terminie, scal nakładające się promocje i preferuj wąskie reguły zamiast tych obejmujących cały katalog i zawierających długie listy ograniczeń.
7.3 Filtry dat w raportach oszukują indeksy
Opakowanie kolumny w funkcję sprawia, że jej indeks staje się bezużyteczny. Niestandardowe pulpity nawigacyjne i eksporty CSV robią to stale.
-- Powolne: funkcja blokuje dostęp do indeksu.
WYBIERZ LICZNIK(*) Z ps_orders GDZIE DATA(date_add) = '2026-03-14';

-- Szybkość: półotwarty zakres utrzymuje indeks w grze.
WYBIERZ LICZBĘ(*) Z ps_orders
GDZIE data_dodania >= '2026-03-14 00:00:00'
  AND date_add < '2026-03-15 00:00:00';
Filtry YEAR(date_add) i grupowanie DATE_FORMAT() mają tę samą wadę. Przepisz je jako zakresy wszędzie tam, gdzie kontrolujesz kod. Jeśli nie jest to możliwe — na przykład w module o zamkniętym kodzie źródłowym — MySQL 8.0.13 i nowsze wersje obsługują kluczowe części funkcyjne, dzięki czemu można indeksować samo wyrażenie. MariaDB nie ma odpowiednika, chociaż indeksowana kolumna generowana w tym przypadku osiąga ten sam rezultat.
7.4 Ekrany zamówień Back Office łączą się zbyt często
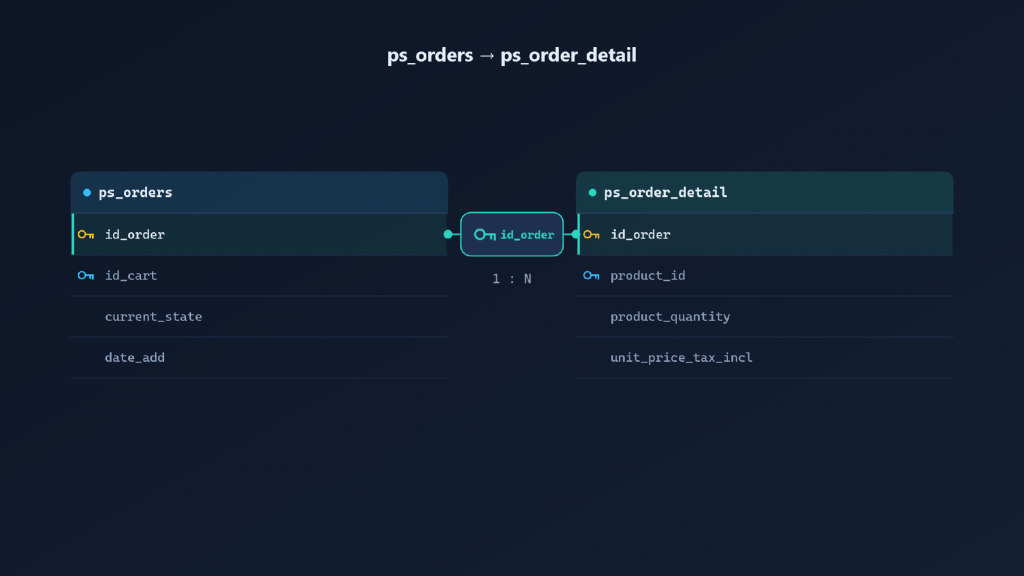
Lista zamówień administratora łączy tabele ps_orders z tabelami ps_customer, stanem zamówienia i tłumaczeniami oraz tabelami przewoźnika, kraju i sklepu. Następnie łączy nazwy do wyszukiwania, stosuje filtr LIKE, sortuje i dzieli na strony.
Wynikają z tego dwa problemy. Filtrowanie lub sortowanie po połączonej lub przetłumaczonej kolumnie, niezależnie od tego, czy jest to nazwa klienta, etykieta statusu, czy kraj, nie może korzystać z indeksu w ps_orders, więc MySQL najpierw tworzy połączony zbiór, a następnie go sortuje. Co gorsza, koszt śledzi całkowitą liczbę zamówień, a nie rozmiar strony, co wyjaśnia, dlaczego ekran pogarsza się wraz z rozwojem sklepu.
Niektóre środki zaradcze nic nie kosztują: zmniejsz domyślny rozmiar strony, zawęź filtr statusu i przeszkol personel, aby wyszukiwał według numeru zamówienia zamiast bezmyślnie przeszukiwać strony.
7.4 Zastosuj bezpieczne poprawki: strategia indeksowania, która przetrwa aktualizacje
Indeksy są umieszczane na końcu, nigdy na początku. Oto kolejność, która obowiązuje:
- Przepisz dowolny kod SQL, który posiadasz. Usuń funkcje z filtrowanych kolumn i usuń łączenia, których nikt nie czyta.
- Ogranicz obciążenie pracą. Zlikwiduj zasady dotyczące martwych koszyków, zaostrz filtry administracyjne.
- Odśwież statystyki za pomocą polecenia ANALYZE TABLE, a następnie uruchom polecenie EXPLAIN po raz drugi.
- Dodaj pojedynczy indeks. Zmierz go przed i po.
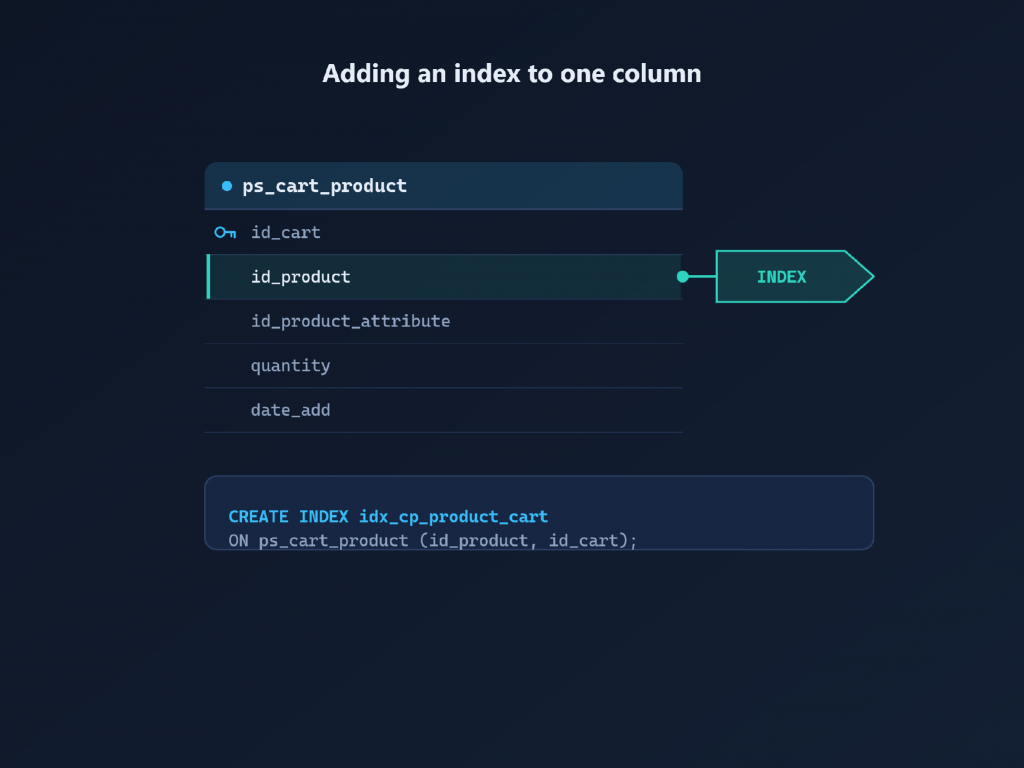
Każdy indeks spowalnia zapisy i zużywa przestrzeń w puli buforów, a tabele kartotek absorbują duży ruch zapisu. Dlatego dodawaj je celowo:
-- Przykłady. Najpierw przetestuj na odrestaurowanej kopii produkcyjnej i potwierdź za pomocą
-- POKAŻ INDEKS, że równoważny indeks jeszcze nie istnieje.
UTWÓRZ INDEKS idx_cp_product_cart NA ps_cart_product (id_product, id_cart);
UTWÓRZ INDEKS idx_cart_dateupd_shop WŁĄCZONY ps_cart (date_upd, id_shop);
Oto kilka zasad, które zapewniają bezpieczeństwo indeksowania tabeli zamówień PrestaShop podczas aktualizacji rdzenia i modułów:
- Nigdy Zmień klucz podstawowy lub dodaj ograniczenie UNIQUE do tabeli głównej. Kod główny zależy od istniejącego kształtu klucza, a indeks unikalny może uniemożliwić prawidłowe wstawianie danych do tabeli.
- Nigdy Usuń indeks główny, ponieważ jedno zapytanie testowe go zignorowało. Inny kontroler prawie na pewno z niego korzysta.
- Dodaj charakterystyczny prefiks do nazw niestandardowych indeksów, aby kolejny programista mógł odróżnić Twoje indeksy od indeksów rdzeniowych.
- Zachowaj każdy niestandardowy indeks w ramach migracji wersjonowanej za pomocą skryptu wycofywania, a następnie po każdej aktualizacji przeprowadź ponowną weryfikację za pomocą polecenia SHOW INDEX.
- Podczas okresu konserwacji twórz indeksy w bardzo dużych tabelach lub korzystaj z internetowego narzędzia do zmiany schematu, ponieważ blokujące polecenie ALTER TABLE może zakłócić bieżące pobieranie danych.
8.0 Przed dodaniem sprzętu usuń i zarchiwizuj stare dane z kartridża
Indeksy pomagają, ale zmniejszenie zbioru roboczego często pomaga bardziej. Porzucone wózki mieszczą większość ciężaru własnego, więc najpierw je zinwentaryzuj:
-- Tylko do odczytu. Jaka część ps_cart jest niepotrzebna?
WYBIERZ LICZBĘ(*) JAKO porzucone_koszyki
Z ps_cart c
LEWE DOŁĄCZENIE ps_orders o WŁĄCZONE o.id_cart = c.id_cart
GDZIE o.id_order JEST NULL
  AND c.date_upd < DATE_SUB(TERAZ(), INTERWAŁ 12 MIESIĘCY);
Kilka zasad jest niepodlegających negocjacjom. Nigdy nie usuwaj koszyka, za którym znajduje się zamówienie, ponieważ ekrany zamówień i generowanie faktur nadal odczytują te dane. Powyższy warunek LEFT JOIN … IS NULL stanowi ochronę. Wyczyść wiersze podrzędne przed wierszami nadrzędnymi, w tym ps_cart_product, a także wszelkie tabele modułów z kluczem id_cart. Najpierw wykonaj kopię zapasową, przećwicz na przywróconej kopii, a następnie uruchom usuwanie danych produkcyjnych w małych partiach zamiast jednej długiej transakcji w godzinach handlowych.
Zachowaj same zamówienia. Zasady przechowywania faktur i dokumentów podatkowych różnią się w zależności od jurysdykcji, dlatego archiwizuj je, a nie usuwaj, gdy potrzebujesz zmniejszyć ich liczbę.
Tabele się uzupełniają, co oznacza, że jedno czyszczenie w najlepszym razie zapewni Ci miesiące. Skryptuj czyszczenie, opakowuj je w powyższą kontrolę kolejności i przekaż zadanie planiście. Ręczne wpisywanie operacji usuwania danych produkcyjnych o 2 w nocy to przyczyna wypadków. Zakończ poleceniem ANALYZE TABLE, aby optymalizator nauczył się nowego rozkładu wierszy.
9.0 Obserwuj uważnie, inaczej wydajność bazy danych PrestaShop spadnie
Regresje pojawiają się po cichu. Aktualizacja modułu generuje jedno nieostrożne zapytanie, nikt tego nie zauważa, a zgłoszenia do pomocy technicznej pojawiają się tydzień później. Rutynowe kontrole za każdym razem przewyższają reakcję na incydenty.
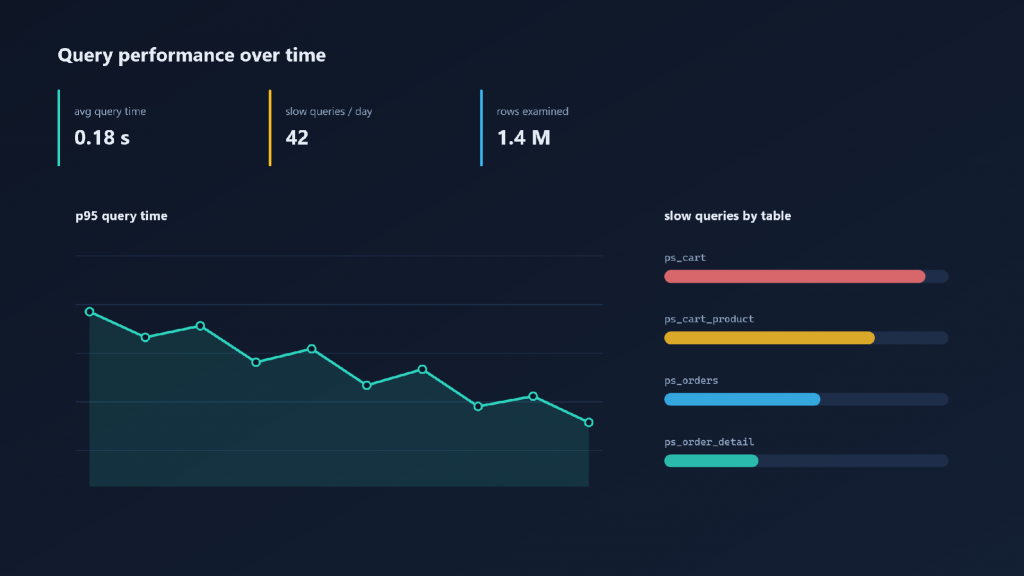
- Zaplanuj podsumowanie. Uruchamiaj pt-query-digest co tydzień na rotowanych, wolnych logach i porównuj odciski palców z tygodnia na tydzień. Nowe wpisy wcześnie ujawniają regresje.
- Zapytanie do tabel digest. Schemat wydajności MySQL agreguje wszystkie polecenia w sposób ciągły, a schemat sys udostępnia czytelne widoki, takie jak statement_analysis i statements_with_full_table_scans.
- Atrybuty zapytań do kodu. Narzędzie APM informuje, który hak, kontroler lub moduł wysłał zapytanie. Dziennik slow podaje nazwę polecenia; APM podaje nazwę kodu do poprawienia.
- Skala odczytuje się oddzielnie. Własny PrestaShop skalowanie dokumentacji Zaleca pojedynczą instancję zapisu z replikami odczytu, ponieważ front-office generuje znacznie więcej odczytów niż zapisów. Sugeruje również analizę tabel po dużych importach, aby optymalizator działał na podstawie bieżących statystyk.
- Daj buforowi miejsce. Jeśli baza danych jest właścicielem serwera, podnieś parametr innodb_buffer_pool_size, aż pomieści tyle zestawu roboczego, na ile Cię stać. Pozostaw go ciasnym, a sklep PrestaShop o dużym natężeniu ruchu osiągnie ten pułap w ciągu kilku dni.
10.0 Wniosek
Wykrywanie powolnych zapytań SQL w PrestaShop to praca metodyczna, a nie detektywistyczna. Loguj z rozsądnym progiem, sortuj według czasu całkowitego i uruchom EXPLAIN na wszystkim, co znajduje się na górze. Następnie przeczytaj plan, nie pochlebiając mu. Typ ALL, klucz NULL lub użycie sortowania plików w Extra – każde z nich wskazuje na konieczność przepisania kodu lub indeksowania.
Następnie należy skupić się na samych danych. Wyczyść porzucone koszyki, archiwizuj stare rekordy, weryfikuj ulepszenia za pomocą rzeczywistych zapytań zamiast testów syntetycznych i zaplanuj kontrole, aby regresje ujawniły się, zanim klienci je znajdą. Sklepy, które stosują tę pętlę, utrzymują responsywność procesu płatności w miarę wzrostu liczby zamówień, a ich zaplecze pozostaje użyteczne na dużą skalę.
Jeśli w tym tygodniu zrobisz tylko jedną rzecz, włącz dziennik wolnych zapytań w najbardziej obciążonym sklepie i przeczytaj dziesięć najpopularniejszych wpisów. Ta pojedyncza lista zazwyczaj wskazuje, gdzie w kolejnym miesiącu należy zająć się pracą nad bazą danych.
W Knowband pomagamy właścicielom sklepów PrestaShop zwiększać wydajność, skalowalność i stabilność dzięki niezawodnym wtyczkom PrestaShop, opracowywaniu niestandardowych funkcji witryn internetowych i tworzeniu aplikacji.
Potrzebujesz pomocy? Skontaktuj się z nami pod adresem [email protected] lub odwiedź biuro pomocy Knowband.


)